


使用BERT进行LLM抽取式摘要
内容提要
本文介绍了抽取式文本摘要的概念和利用BERT等NLP模型增强它的方法。抽取式摘要通过提取关键句子来快速理解大量文档,具有广泛应用。使用LLMs进行抽取式摘要的过程包括文本解析、特征提取、句子评分和选择汇总。文章还讨论了使用BERT模型进行抽取式摘要的挑战。抽取式摘要是信息泛滥时代的实用工具,随着自然语言处理的发展,它将变得更加重要。
延伸解读
抽取式摘要与生成式摘要的本质区别
文章明确指出,抽取式摘要直接从原文中提取句子,保留原始措辞和结构,不进行改写或转述;而生成式摘要则会生成原文中不存在的新句子。这种区别决定了抽取式摘要在需要保持信息准确性和作者原意的场景中更具优势,例如新闻、学术论文或法律文书。但代价是摘要可能不够流畅,或包含冗余信息。
BERT抽取式摘要的实操流程与关键参数
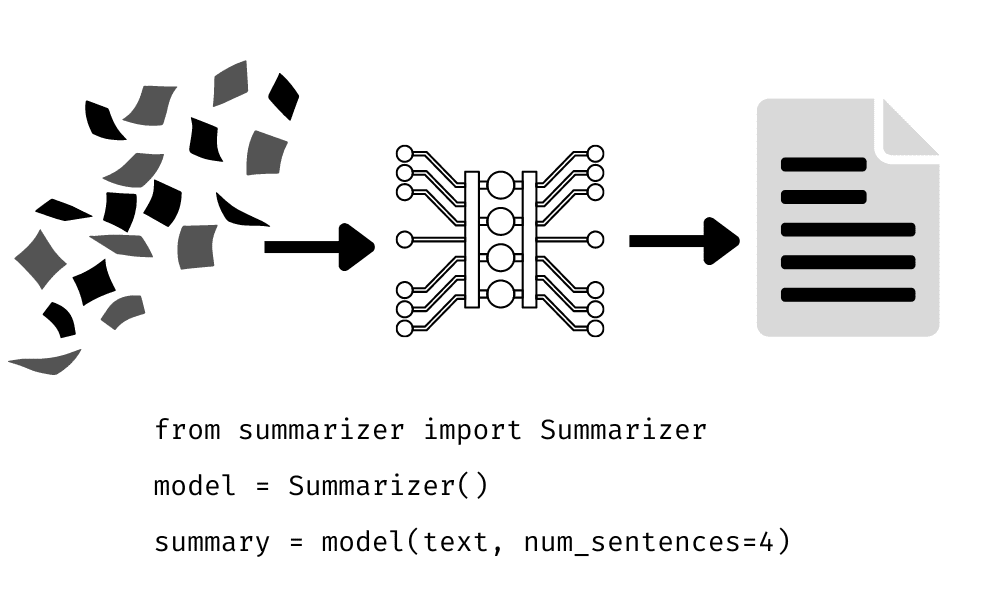
文章提供了一个完整的代码示例:安装bert-extractive-summarizer库,初始化Summarizer模型,然后调用model(text, num_sentences=4)生成摘要。其中num_sentences参数直接控制输出摘要的句子数量,用户可根据需要调整。该模型基于预训练BERT并针对抽取式摘要任务进行了微调,能够自动评估句子重要性并选出得分最高的句子。
LLM抽取式摘要的三大局限
文章总结了使用LLM进行抽取式摘要时面临的挑战:一是上下文理解有限,长文本中可能遗漏细微含义;二是训练数据中的偏见可能被模型学习并反映在摘要中,导致不公平的表述;三是处理法律、医学等专业术语时效果不佳,因为通用训练数据缺乏领域知识。这些局限意味着在实际应用中需要谨慎评估,必要时引入领域数据微调。
抽取式摘要的适用场景与价值
抽取式摘要适用于快速理解大量文档,如新闻、学术论文和长篇报告。它通过提取关键句子帮助读者节省时间,同时避免改写带来的潜在偏差。文章通过一个GPU历史的例子展示了BERT如何从三段落中选出四个最重要的句子,生成连贯摘要。在信息过载的时代,这种技术能有效提升信息获取效率,随着NLP发展将变得更加重要。
Q&A
什么是抽取式文本摘要?
抽取式文本摘要是一种自然语言处理技术,它通过从原文中提取关键句子或短语来生成简洁的摘要,保留原文的措辞和结构,确保信息的准确性。
抽取式摘要和生成式摘要有什么区别?
抽取式摘要直接从原文中提取句子,不改变原文措辞;而生成式摘要则会生成新的句子,可能包含原文中没有的表述,因此抽取式摘要更忠实于原文。
使用LLM进行抽取式摘要的步骤有哪些?
使用LLM进行抽取式摘要主要包括四个步骤:文本解析、特征提取、句子评分和选择汇总。
BERT如何用于抽取式摘要?
BERT可以通过预训练模型进行抽取式摘要,例如使用bert-extractive-summarizer库,该库利用BERT分析文本并提取关键句子,生成摘要。
抽取式摘要面临哪些挑战?
抽取式摘要使用LLM时面临上下文理解限制、训练数据偏见以及处理专业术语的困难等挑战。
抽取式摘要有哪些应用场景?
抽取式摘要广泛应用于新闻文章、学术论文和长篇报告等领域,帮助快速理解大量文档。
