


宣布State Reader API:全新的“Statestore”数据源
内容提要
Databricks Runtime 14.3引入了State Reader API,允许用户访问和分析Structured Streaming的内部状态数据。该API有助于开发、调试和故障排除有状态的Structured Streaming工作负载。它包括两个新的DataFrame格式选项:state-metadata和statestore。State Reader API简化了有状态流应用程序的开发和调试,提供了并行性和偏斜度的洞察,并帮助调查生产问题。该API已包含在Apache Spark 4.0.0中。
延伸解读
State Reader API 的适用场景与限制
State Reader API 主要用于开发调试、性能分析和生产问题排查,而非持续运行。它不是一个流式数据源,不能替代常规的流处理逻辑。开发者可以将其封装为工作流,定期检索状态元数据并分析,但需注意避免在生产环境中长期开启。
如何利用状态元数据发现潜在问题
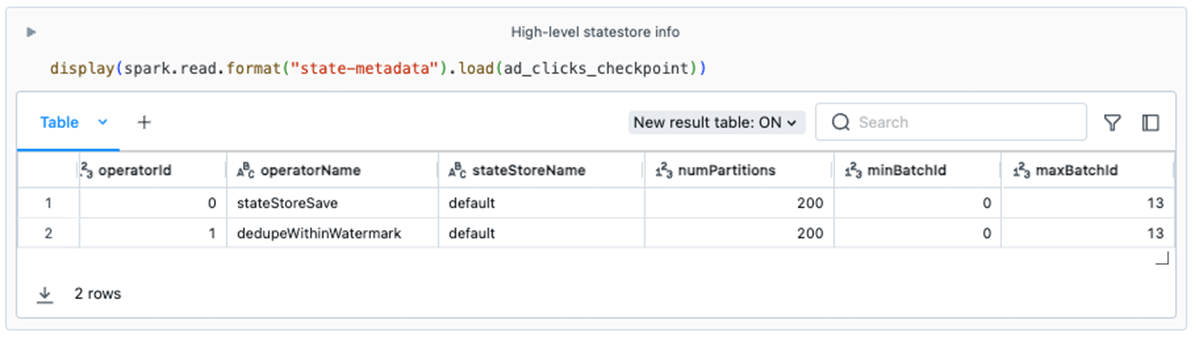
通过 state-metadata 格式,可以获取状态存储的高层信息,如状态操作符数量、批次 ID 范围和分区数。例如,若 minBatchId 不随时间增加,可能意味着状态数据未清理,存在无限增长风险。此外,默认的 200 个 shuffle 分区可能不适合大规模有状态负载,需根据实际情况调整。
使用 statestore 格式进行细粒度分析与偏斜检测
statestore 格式允许查看具体的键值数据,便于验证业务逻辑和排查数据异常。结合 DataFrame 操作,可以分析状态数据在分区间的分布,检测偏斜。例如,若少数分区承载了大量键,可能导致性能瓶颈,需考虑重新分区或调整并行度。
Q&A
State Reader API的主要功能是什么?
State Reader API允许用户访问和分析Structured Streaming的内部状态数据,帮助开发、调试和故障排除有状态的工作负载。
State Reader API包含哪些新的DataFrame格式选项?
State Reader API包含两个新的DataFrame格式选项:state-metadata和statestore。
如何使用state-metadata格式获取状态数据?
可以通过命令spark.read.format('state-metadata').load('<checkpointLocation>')来获取状态数据。
State Reader API如何帮助开发者调试应用程序?
API允许开发者直接查看状态、输入新记录并查询状态,从而简化了开发过程并提高了调试效率。
State Reader API在生产环境中如何应用?
在生产环境中,State Reader API可以帮助分析数据不一致性和访问限制,支持调查生产问题。
State Reader API的使用限制是什么?
State Reader API不适合持续使用,但可以通过工作流自动化状态元数据的检索和分析。
