

AlphaCodium:引领代码生成新境界,从提示工程到流程工程 [译]
内容提要
本文介绍了AlphaCodium,一种新的代码生成方法,通过测试、分阶段和迭代处理流程,提升了大语言模型在处理代码问题上的能力。AlphaCodium在挑战性的代码生成数据集上表现出色,性能超越了之前的研究成果,并减少了计算资源的需求。作者分享了AlphaCodium的解决方案和评估脚本,并讨论了与其他方法的比较结果。AlphaCodium在智能编程领域具有卓越潜力。
延伸解读
流程工程为何比提示工程更有效
文章指出,代码生成任务与普通自然语言处理不同,需要严格遵循语法、处理边界情况并关注问题细节,因此常规提示优化技巧效果有限。AlphaCodium 将重点从单一提示设计转向分阶段、迭代的流程工程,通过预处理和代码迭代两个阶段,让模型在运行和修正代码的过程中逐步逼近正确答案。这种思路更贴合代码任务的可验证特性,即利用测试反馈来驱动改进。
AI 生成测试与测试锚点的作用
AlphaCodium 在公开测试之外,让模型生成额外的 AI 测试,以覆盖公开测试未涉及的边缘情况。由于 AI 测试可能出错,文章引入“测试锚点”技术:先通过所有公开测试并将其固定为锚点,再逐个检查 AI 测试,只有通过锚点的代码修正才被接受。这能避免因错误测试而误改代码,提升迭代过程的稳定性。同时,将 AI 测试按难易排序,有助于在早期建立锚点,为后续复杂测试提供保障。
结构化输出与 YAML 的实用考量
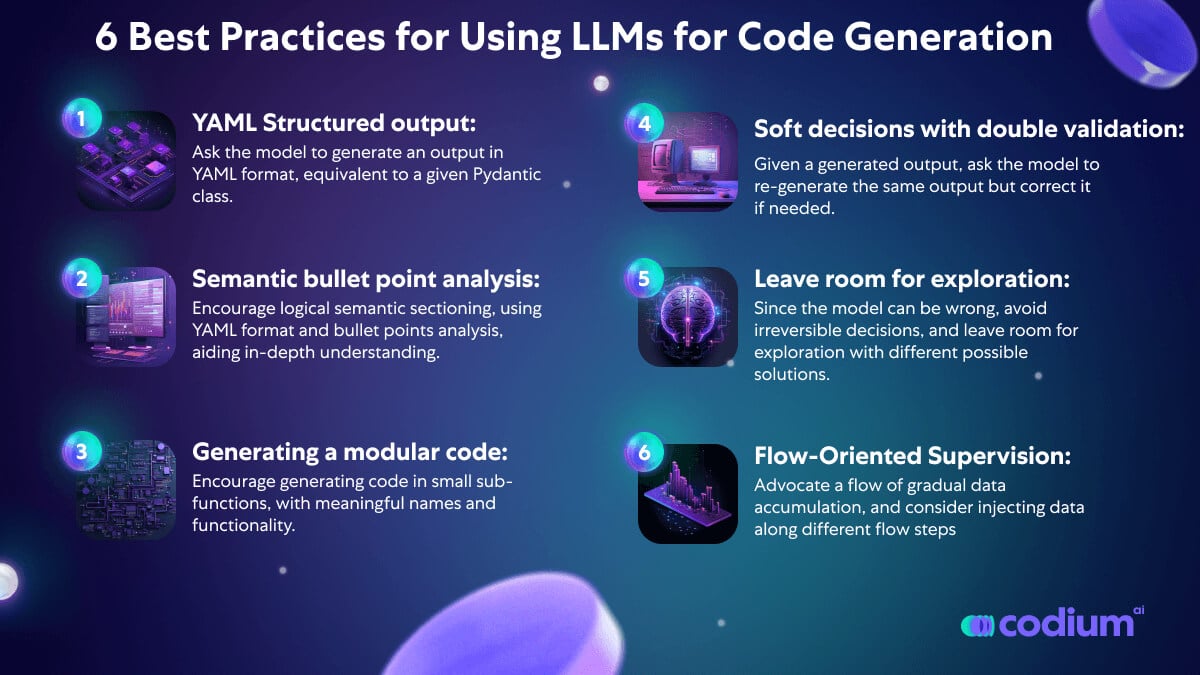
文章强调使用结构化输出(如 YAML 格式)来组织模型回答,减少对提示工程“暗黑知识”的依赖,使复杂任务以类似代码的方式呈现。相比 JSON,YAML 更适合代码生成,因为生成的代码常包含引号和特殊字符,YAML 的块标量风格只需缩进即可合法,且 token 更少,能降低成本和推理时间,同时减少模型对非关键 token 的关注,提升输出质量。
效率与可复现性的对比视角
在 CodeContests 上,AlphaCodium 使用 GPT-4 将 pass@5 从直接提示的 19% 提升到 44%,且每个问题约需 15-20 次 LLM 调用,五次尝试约 100 次调用。相比之下,AlphaCode 采用大量采样和分类策略,LLM 调用次数多出数个数量级。文章还指出,AlphaCode 和 CodeChain 未提供可复现的端到端评估脚本,而 AlphaCodium 开源了解决方案和评估脚本,便于社区复现和比较。
Q&A
AlphaCodium 是什么?它和普通的提示工程有什么区别?
AlphaCodium 是一种新的代码生成方法,它基于测试、分阶段、专注于代码的迭代处理流程,而非仅仅优化提示词。与传统的提示工程不同,AlphaCodium 强调通过预处理阶段(如问题反思、生成额外测试)和代码迭代阶段(反复运行和修正代码)来提升大语言模型解决编程问题的能力。
AlphaCodium 在 CodeContests 数据集上取得了怎样的效果?
在 CodeContests 验证集上,使用 AlphaCodium 流程后,GPT-4 的准确率(pass@5)从单一直接提示的 19% 提升到了 44%。AlphaCodium 在性能上超越了之前的研究成果如 AlphaCode,且所需计算资源大大减少。
AlphaCodium 的流程包括哪些主要阶段?每个阶段做什么?
AlphaCodium 流程分为两个主要阶段:预处理阶段和代码迭代阶段。预处理阶段使用自然语言对问题进行推理,包括问题反思、公开测试的逻辑分析、构思可能的解决方案、解决方案评估、补充 AI 测试等步骤。代码迭代阶段则包括初步代码方案、公开测试的迭代优化和 AI 测试的迭代优化,通过反复运行和修正代码来通过测试。
为什么 AlphaCodium 选择 YAML 而不是 JSON 作为结构化输出格式?
因为生成的代码经常包含单引号、双引号和特殊字符,在 JSON 格式中模型很难正确放置这些字符,而 YAML 采用块标量风格,只需遵循缩进规则,任何正确缩进的文本或代码都是合法的。此外,YAML 输出的 token 更少,意味着更低的成本和更快的推理时间,同时因为模型需要关注的非关键 token 更少,所以质量也得到提升。
AlphaCodium 中的“测试锚点”技术是什么?它解决了什么问题?
测试锚点技术是一种在迭代优化代码时,将已知正确的公开测试作为基准(锚点),然后逐个检查 AI 生成的测试。通过的测试加入锚点列表,未通过的则默认为代码有误并尝试修正,且修正后的代码必须通过所有锚点测试。这解决了当 AI 生成的测试本身有误时,难以判断是代码问题还是测试问题,避免错误地修改代码。
AlphaCodium 与 AlphaCode 在计算资源消耗上有什么不同?
AlphaCodium 解决每个问题大约需要调用 15-20 次大语言模型,五次尝试约需 100 次调用。而 AlphaCode 采用穷举策略,假设每次尝试调用一次,10 次尝试从 10 万个方案中筛选,就需要调用 100 万次大语言模型,比 AlphaCodium 多出四个数量级。AlphaCodium 在达到相似准确率时,所需的 LLM 调用次数少了数千倍。
